GenAI와 RAG(Retrieval-Augmented Generation)를 기업 환경에 적용하면 GPU와 네트워크뿐 아니라 데이터를 어디에 저장하고, 언제 이동시키며, 어떤 데이터에 어느 수준의 성능을 제공할 것인지도 중요한 인프라 설계 요소가 됩니다.
특히 AI 데이터는 하나의 형태로만 존재하지 않습니다.
웹 크롤링 데이터, 사내 문서, 로그와 같은 원천 데이터부터 전처리된 학습 데이터, 모델 Checkpoint, Vector Database의 인덱스와 원본 문서까지 데이터의 생성 목적과 접근 패턴이 서로 다릅니다.
모든 데이터를 최고 성능의 스토리지에 저장하면 성능 측면에서는 단순하지만, 저장 용량과 비용이 빠르게 증가할 수 있습니다.
반대로 비용 절감만을 우선해 모든 데이터를 저성능 스토리지에 배치하면 AI 학습이나 검색 과정에서 스토리지 I/O가 병목으로 작용할 수 있습니다.
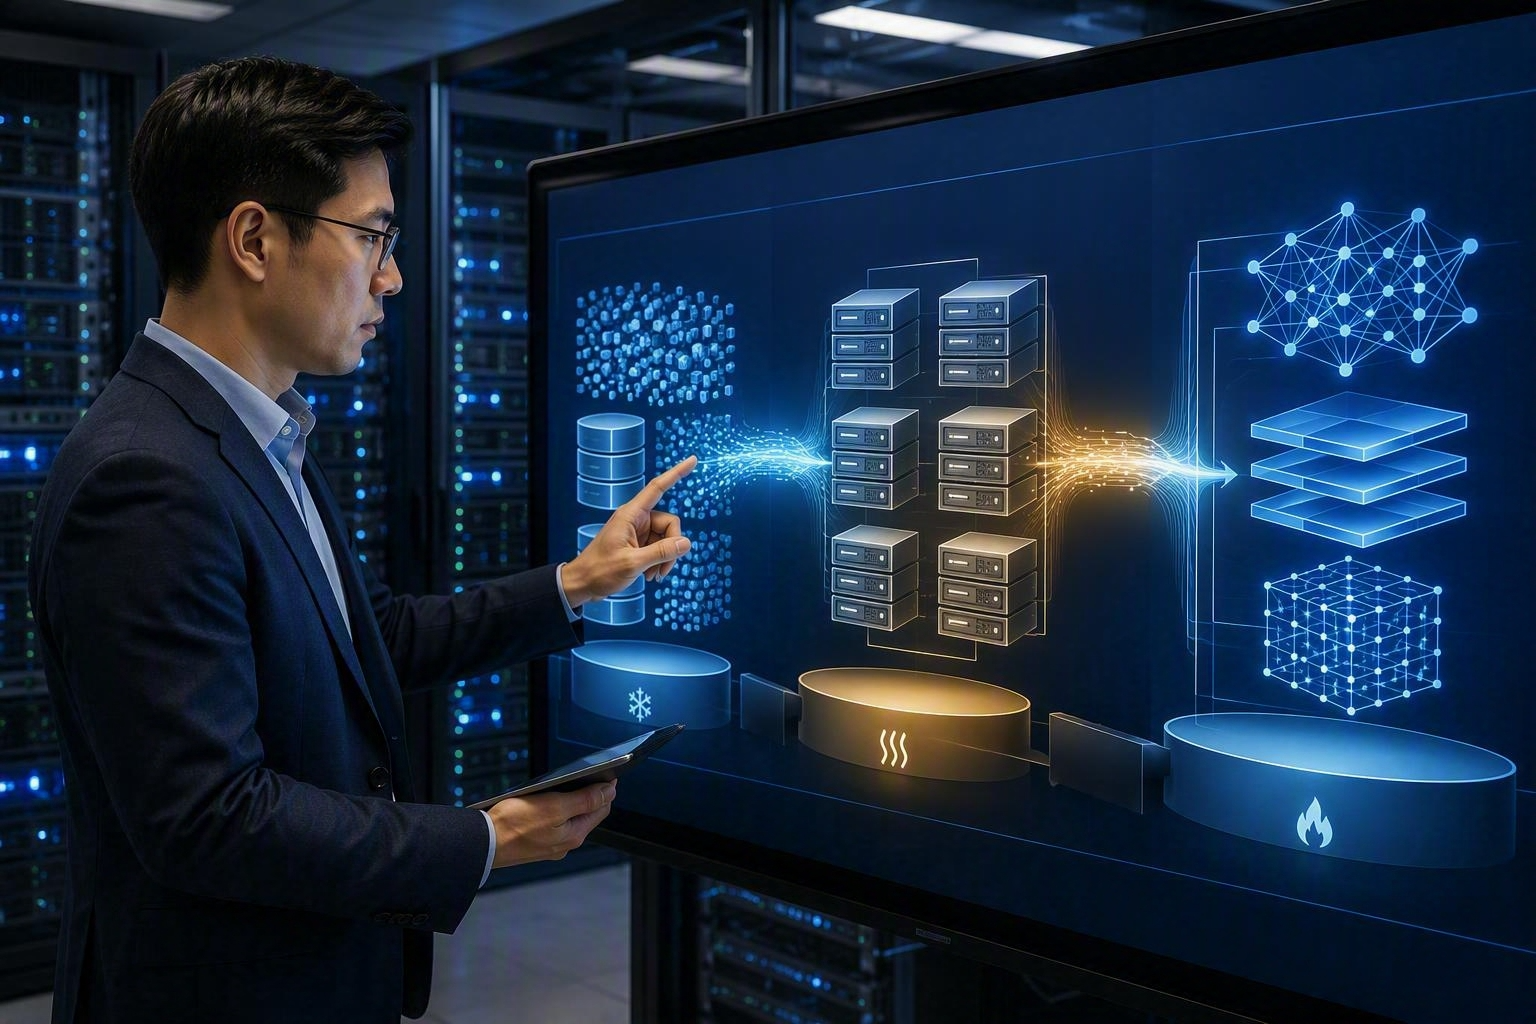
따라서 Enterprise AI Infrastructure에서는 데이터의 수명주기와 접근 패턴에 따라 스토리지 성능 계층을 구분하는 Storage Tiering 전략이 필요합니다.
Training Dataset의 스토리지 요구사항을 이해하기 위해서는 [Enterprise AI Workload에서 Storage I/O 병목이 발생하는 이유]에서 AI Workload의 I/O 특성과 병목이 발생하는 구조를 먼저 살펴보는 것도 좋습니다.
Enterprise AI Workload에서 발생하는 Storage I/O 병목의 구조적인 원인은 1편에서, NVMe-oF와 병렬 파일 시스템을 활용한 스토리지 아키텍처는 2편에서 자세히 살펴볼 수 있습니다.
이번 글에서는 그 다음 단계로 AI 데이터의 Lifecycle에 맞춰 Hot·Warm·Cold Storage를 어떻게 배치하고, RAG 환경에서는 데이터와 Vector Index를 어떻게 구분해 배치할 것인지를 중심으로 살펴보겠습니다.
[연재] Enterprise AI Infrastructure를 위한 High-Performance Storage Architecture 구축 실무
- 1편: Enterprise AI Workload에서 Storage I/O 병목이 발생하는 이유: 레거시 NAS/SAN 아키텍처의 구조적 한계
- 2편: NVMe-oF와 병렬 파일 시스템(GPFS·WEKA·Lustre): Enterprise AI Storage Architecture 설계
- 3편: GenAI 및 RAG 데이터 파이프라인을 위한 Enterprise Storage Tiering과 Data Lifecycle 설계 (현재 글)
- 4편: Enterprise AI Storage 도입 전략: GPU 활용률, TCO 최적화 및 DR 통합 아키텍처
1. 왜 Enterprise AI에는 Storage Tiering이 필요한가
AI 데이터는 생성된 이후 계속 같은 방식으로 사용되지 않습니다.
예를 들어 새로운 AI 모델을 학습하기 위해 수집한 원천 데이터는 초기에는 자주 처리될 수 있지만, 전처리가 끝난 이후에는 접근 빈도가 크게 감소할 수 있습니다.
반면 학습에 사용되는 Dataset이나 Vector Database의 Index는 반복적인 학습과 검색 과정에서 높은 성능이 요구될 수 있습니다.
따라서 다음과 같은 질문이 필요합니다.
모든 AI 데이터를 동일한 성능의 스토리지에 저장해야 할까?
반드시 그렇지는 않습니다.
스토리지 계층을 결정할 때는 단순히 데이터의 크기만 보는 것이 아니라 다음과 같은 특성을 함께 고려해야 합니다.
- 데이터에 얼마나 자주 접근하는가
- 읽기와 쓰기 중 어떤 I/O가 많은가
- 낮은 지연시간이 필요한가
- 높은 처리량이 필요한가
- 데이터가 얼마나 자주 변경되는가
- 다시 생성하거나 재수집할 수 있는 데이터인가
- 복구 우선순위가 높은 데이터인가
- 얼마나 오랫동안 보관해야 하는가
- 저장 비용뿐 아니라 데이터 이동 비용이 얼마나 발생하는가
- 보안·컴플라이언스 정책상 별도의 보호가 필요한가
결국 Storage Tiering은 단순한 고성능 스토리지와 저비용 스토리지를 나누는 작업이 아닙니다.
데이터의 사용 목적과 Lifecycle에 맞춰 적절한 성능과 비용 구조를 선택하는 데이터 배치 정책에 가깝습니다.
2. GenAI 데이터의 Lifecycle을 먼저 구분해야 한다
Enterprise AI 환경에서는 데이터를 다음과 같은 단계로 구분해 볼 수 있습니다.
① Raw Data
Raw Data는 AI 학습이나 검색 시스템에 투입하기 전에 수집되는 원천 데이터입니다.
예를 들면 다음과 같습니다.
- 웹 크롤링 데이터
- 사내 업무 문서
- 로그 데이터
- 이미지와 영상
- 각종 원천 데이터베이스 추출 데이터
이 단계에서는 데이터의 양이 상당히 커질 수 있습니다.
하지만 모든 Raw Data가 항상 높은 I/O 성능을 필요로 하는 것은 아닙니다.
데이터 전처리나 재처리, 모델 재학습, 감사 및 검증 등의 목적으로 다시 접근할 가능성이 있기 때문에 접근 빈도와 재사용 가능성을 기준으로 적절한 계층을 선택하는 것이 중요합니다.
② Training Dataset
Raw Data를 정제하고 전처리하면 실제 학습에 사용하는 Training Dataset이 만들어집니다.
이 데이터는 모델 학습 과정에서 반복적으로 읽힐 수 있기 때문에 Raw Data와는 다른 스토리지 요구사항을 가질 수 있습니다.
특히 다음 요소를 함께 고려해야 합니다.
- 데이터셋의 크기
- 학습 프레임워크
- 데이터 로딩 방식
- GPU 수와 병렬 처리 구조
- 필요한 처리량
- IOPS
- 스토리지와 GPU 사이의 네트워크 구조
- 데이터 접근 패턴
따라서 Training Dataset에는 일반적으로 충분한 처리량과 IOPS, 낮은 지연시간을 제공할 수 있는 스토리지 계층을 우선 검토할 수 있으며, 구체적인 요구사항은 실제 Workload의 측정 결과를 바탕으로 결정하는 것이 적절합니다.
다만 모든 AI 학습 환경이 동일한 I/O 패턴을 갖는 것은 아니므로 실제 배치 계층은 Workload 측정 결과를 기반으로 결정해야 합니다.
앞서 설명한 AI Storage I/O 병목 문제를 이해하려면 Enterprise AI Workload에서 Storage I/O 병목이 발생하는 이유: 레거시 NAS/SAN 아키텍처의 구조적 한계 의 내용을 함께 살펴보는 것이 좋습니다.
③ Model Checkpoint
Model Checkpoint는 학습 중인 모델의 가중치와 상태 정보를 저장한 데이터입니다.
학습 환경에 따라 Checkpoint의 크기와 저장 빈도는 달라질 수 있으며, 저장 시점에 I/O가 집중될 가능성도 있습니다.
따라서 Checkpoint 저장 영역을 설계할 때는 단순한 저장 용량뿐 아니라 다음 요소를 확인해야 합니다.
- Checkpoint 크기
- 저장 주기
- 동시 저장 작업 수
- 필요한 쓰기 처리량
- 복구 시 읽기 성능
- 보관 기간
- 복구 우선순위
특히 Checkpoint는 단순한 임시 데이터가 아니라 학습 중단 이후 작업을 재개하거나 특정 모델 상태를 복구하는 데 필요한 데이터가 될 수 있으므로 보존 정책까지 함께 설계해야 합니다.
④ Vector Database와 Inference Data
RAG 환경에서는 Vector Database와 검색 인덱스도 중요한 데이터 계층을 구성합니다.
사용자의 질의가 들어오면 Vector Search를 통해 관련 문서를 검색하고, 검색된 정보를 LLM의 입력 데이터로 전달하게 됩니다.
따라서 자주 검색되는 Vector Index나 캐시 데이터는 접근 빈도와 지연시간 요구사항을 기준으로 상대적으로 높은 성능의 Storage Tier에 배치하는 방안을 검토할 수 있습니다.
여기서 중요한 점은 Vector Database의 전체 데이터를 반드시 최고 성능의 스토리지에 저장해야 한다는 의미는 아니라는 것입니다.
Vector Index의 크기와 접근 패턴, 캐시 구조, 데이터베이스 엔진의 특성에 따라 실제 배치 전략은 달라질 수 있습니다.
⑤ 데이터 유형별 Lifecycle·보존정책표
| 데이터 유형 | 주요 용도 | 초기 Tier 후보 | 이동 트리거 | 보존 판단 | 주의사항 |
| Raw Data | 원천 데이터 보관·재처리 | Warm / Cold | 수집·정제 완료 후 접근 빈도 감소 | 재수집 가능 여부·감사 요구 | 원본 삭제 전 재생성 가능성 확인 |
| Training Dataset | 모델 학습 | Hot / Warm | 학습 종료·재학습 계획 | 다음 학습 재사용 가능성 | 학습 중에는 높은 처리량 필요 가능 |
| Checkpoint | 학습 상태 저장·복구 | Hot / Warm | 학습 종료 후 일정 기간 미사용 | 재학습 비용·복구 중요도 | 보존본과 복구본을 구분할 필요 |
| Vector Index | RAG 검색 | Hot | 검색 빈도·인덱스 재생성 시간 | 서비스 중요도·재생성 비용 | 저장 위치뿐 아니라 검색 성능 검증 |
| 원본 문서/Payload | 검색 결과의 실제 콘텐츠 | Warm / Hot | 접근 빈도·업무 중요도 | 업무·법규·보존정책 | 권한·개인정보 정책 연계 |
※ Hot/Warm/Cold는 특정 CSP의 상품명을 의미하지 않는다. 실제 Tier 선택은 해당 환경의 성능, 비용, 보존 및 복구 조건으로 검증해야 한다.
3. Hot·Warm·Cold Storage로 나누는 기본 원칙
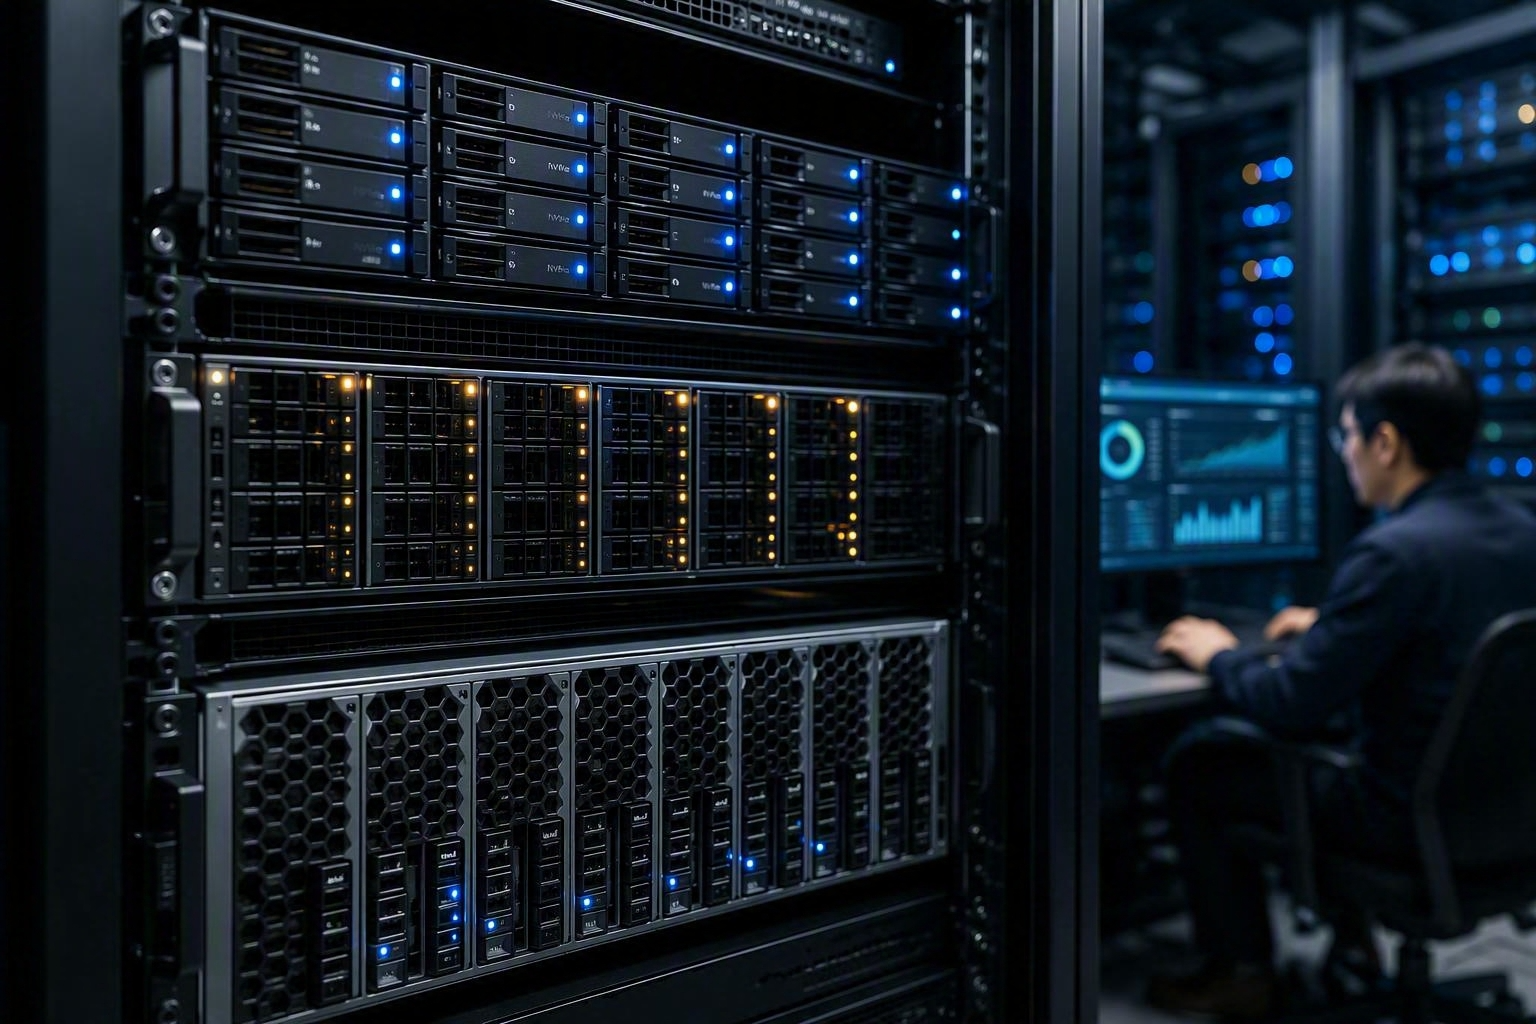
Enterprise AI 환경에서는 데이터의 접근 빈도와 성능 요구사항을 기준으로 Storage Tier를 구분할 수 있습니다.
① Hot Tier
Hot Tier는 현재 AI Workload에서 빈번하게 접근하거나 높은 성능이 필요한 데이터를 배치하는 영역입니다.
대표적으로 다음과 같은 데이터가 대상이 될 수 있습니다.
- 자주 사용되는 Training Dataset
- 자주 검색되는 Vector Index
- Inference Cache
- 높은 I/O 성능이 필요한 AI Workload
스토리지 기술로는 환경에 따라 다음과 같은 구성을 검토할 수 있습니다.
- Local NVMe
- NVMe 기반 스토리지
- NVMe-oF
- GPU Direct Storage와 연계된 구조
핵심은 스토리지 기술 자체보다 실제 AI Workload가 요구하는 처리량과 지연시간을 충족하는지 검증하는 것입니다.
② Warm Tier는 비용과 성능의 균형이 중요하다
Warm Tier는 Hot Tier만큼 빈번하게 접근하지 않지만 일정 수준의 접근 가능성과 성능이 필요한 데이터를 배치하는 영역입니다.
예를 들어 다음과 같은 데이터를 고려할 수 있습니다.
- 최근에 생성된 Checkpoint
- 학습을 기다리고 있는 정제 Dataset
- 재사용 가능성이 있는 Raw Data
- 비교적 자주 접근하는 RAG 원본 데이터
이 영역에서는 Enterprise Object Storage나 고성능 파일·오브젝트 스토리지 등을 환경에 맞게 검토할 수 있습니다.
특히 Object Storage는 대규모 데이터를 저장하고 Lifecycle 정책과 연계하기에 적합한 경우가 있어, 접근 패턴과 성능 요구사항을 고려해 하나의 선택지로 검토할 수 있습니다.
이 구조에서 중요한 것은 Vector Embedding, Document Metadata, 원본 Payload를 동일한 특성의 데이터로 취급하지 않는 것입니다.
다만 Object Storage라고 해서 모든 AI Workload의 Checkpoint나 고성능 학습 데이터를 동일하게 처리할 수 있는 것은 아닙니다.
실제 환경에서는 다음을 확인해야 합니다.
- 네트워크 대역폭
- 동시 접근 수
- 읽기·쓰기 처리량
- Object Storage의 성능 특성
- Metadata 처리 성능
- 애플리케이션 및 AI 프레임워크와의 호환성
따라서 Warm Tier를 구성할 때는 단순히 저장 비용만 비교하기보다 실제 데이터 접근 패턴과 네트워크 이동 비용까지 함께 평가해야 합니다.
③ Cold Tier는 장기보관과 비용 효율성을 고려한다
Cold Tier는 접근 빈도가 낮거나 장기간 보관이 필요한 데이터를 대상으로 합니다.
예를 들면 다음과 같습니다.
- 오래된 Raw Data
- 과거 Dataset
- 이전 버전의 Checkpoint
- 감사 및 보관 대상 데이터
- 장기 보존이 필요한 원본 데이터
환경에 따라 고밀도 HDD 기반 스토리지, Archive Storage, Tape 또는 Public Cloud의 Archive 계층 등을 검토할 수 있습니다.
다만 여기서 한 가지 구분이 필요합니다.
Cold Storage와 Immutable Backup은 같은 개념이 아닙니다.
Cold는 주로 데이터의 접근 빈도와 저장 비용을 기준으로 한 Storage Tier이고, Immutable Backup이나 WORM은 데이터를 변경하거나 삭제하지 못하도록 보호하는 데이터 보호 정책 또는 기술입니다.
따라서 Cold Tier에 저장한다고 해서 자동으로 랜섬웨어에 대한 보호가 확보되는 것은 아닙니다.
중요 데이터라면 Storage Tier와 별도로 다음과 같은 보호 정책을 검토해야 합니다.
- Immutable Storage
- WORM
- 별도 백업
- 접근 권한 분리
- 관리자 계정 분리
- 논리적 또는 물리적 네트워크 분리
- 복구 테스트
4. RAG에서는 Vector와 원본 데이터를 동일하게 볼 필요가 없다
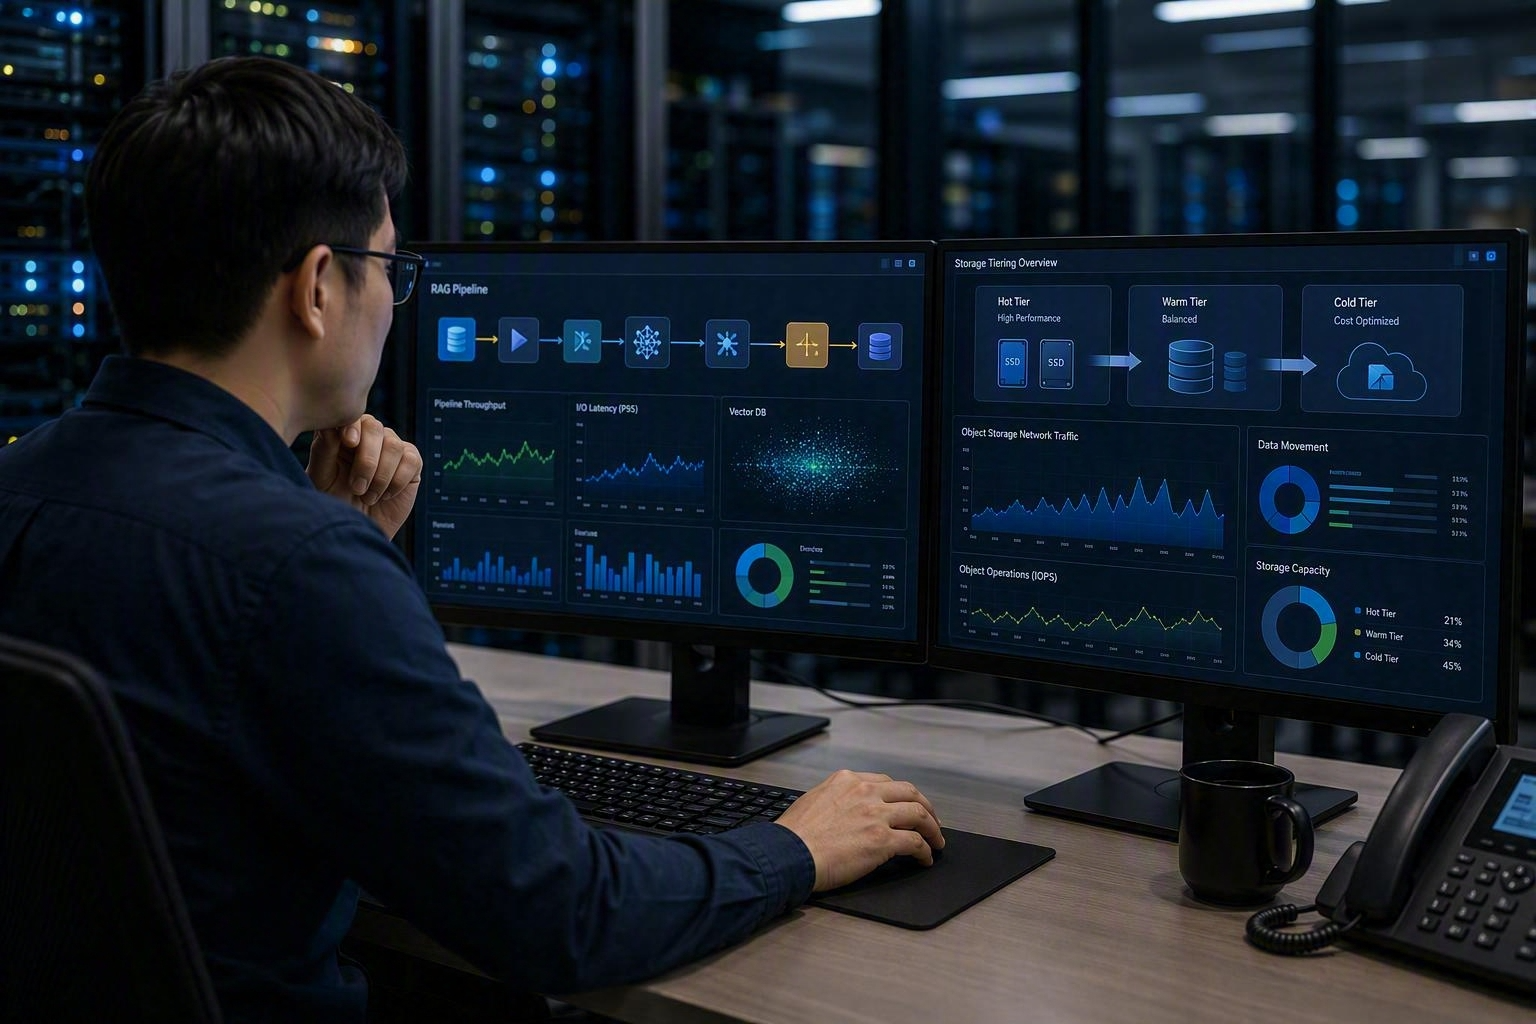
RAG 아키텍처에서는 검색을 위해 생성된 Vector Embedding과 실제 원본 문서가 서로 다른 역할을 합니다.
일반적인 흐름을 단순화하면 다음과 같습니다.
사용자 질의
→ Embedding 생성
→ Vector Database 검색
→ 관련 문서 식별
→ 원본 문서 또는 필요한 Payload 조회
→ LLM에 Context 전달
이 구조에서 중요한 것은 Vector Embedding, Document Metadata, 원본 Payload를 동일한 특성의 데이터로 취급하지 않는 것입니다.
Vector Embedding은 검색을 위한 벡터 표현이고, Metadata는 문서 ID·작성일·부서·권한 등의 정보를 포함할 수 있으며, Payload는 실제 문서 내용이나 이미지 등의 원본 데이터를 의미할 수 있습니다.
따라서 각각의 접근 특성에 맞춰 저장 위치를 다르게 설계할 수 있습니다.
5. RAG 데이터 배치 전략
예를 들어 기업 내부 문서를 RAG에 활용한다고 가정해 보겠습니다.
문서 자체가 상당한 용량을 차지하더라도 실제 검색 과정에서 항상 문서 전체를 읽는 것은 아닙니다.
검색 단계에서는 Vector Index가 먼저 사용되고, 검색 결과에 따라 필요한 원본 문서를 조회하는 방식으로 구성할 수 있습니다.
따라서 다음과 같은 구조를 검토할 수 있습니다.
Hot Tier
- 자주 사용되는 Vector Index
- 검색 성능이 중요한 데이터
- Inference Cache
- 자주 접근하는 검색 관련 데이터
Warm Tier
- 자주 사용하지 않지만 필요할 때 접근해야 하는 원본 문서
- 이미지
- 최근 Dataset
- 재사용 가능성이 높은 데이터
Cold Tier
- 오래된 원본 데이터
- 장기 보관 Dataset
- 이전 버전 데이터
- 감사 및 보존 목적의 데이터
이렇게 구성하면 모든 데이터를 최고 성능의 Storage Tier에 올려놓지 않고도 데이터의 접근 특성에 따라 검색 성능과 저장 비용 사이의 균형을 맞추는 방향으로 설계할 수 있습니다. 다만 실제 배치 기준은 Workload 특성과 성능 요구사항을 바탕으로 검증해야 합니다.
다만 실제 배치 기준은 Vector Database와 RAG Application의 구조에 따라 달라지므로 PoC나 성능 테스트를 통해 검증하는 것이 필요합니다.
RAG 환경에서 Vector Database와 원본 데이터의 역할을 보다 넓은 AI Search 관점에서 이해하려면 [Enterprise AI Search Architecture 설계: NotebookLM, LLM API 그리고 RAG의 역할]도 함께 살펴볼 수 있습니다.
6. Storage Tiering의 핵심은 자동화된 Data Lifecycle이다
Storage Tiering을 수동으로 운영하면 데이터가 계속 Hot Tier에 남거나 불필요한 데이터가 장기간 고성능 스토리지를 점유하는 문제가 발생할 수 있습니다.
Tier 이동 트리거를 시간 기준에서 업무 기준으로 확장
Storage Tiering을 단순히 '30일이 지나면 Cold'처럼 시간만으로 운영하면 실제 업무 패턴을 반영하지 못할 수 있다. 따라서 다음과 같이 접근 빈도와 업무 이벤트를 함께 트리거로 사용하는 방식을 검토할 수 있다.
| 트리거 | 예시 조건 | 권장 검토 | 예외 조건 |
| 접근 빈도 | 최근 N일간 읽기/쓰기 빈도 감소 | Warm/Cold 이동 후보 | 예정된 재학습이 있으면 유지 |
| 학습 상태 | Training 종료 | Dataset/Checkpoint 재분류 | 다음 학습 일정이 임박하면 유지 |
| 서비스 상태 | Vector Index 교체 | 기존 Index를 Warm/Cold 후보로 전환 | Rollback 필요 시 보존 |
| 보존기간 | 업무상 보존기간 도달 | 삭제 또는 Archive 정책 검토 | 법규·감사 보존 요구 우선 |
| 비용 상태 | 고성능 Tier 사용량 증가 | 저비용 Tier 이동 후보 분석 | 성능 저하가 업무에 미치는 영향 검토 |
따라서 Enterprise AI 환경에서는 Data Lifecycle Management와 Tiering Policy를 연결하는 것이 중요합니다.
예를 들어 다음과 같은 정책을 만들 수 있습니다.
데이터 생성
→ Raw Data 저장
→ 데이터 정제
→ Training Dataset 생성
→ 학습 종료
→ Checkpoint 보관
→ 일정 기간 미사용
→ Warm 또는 Cold Tier 이동
→ 장기 보관 정책 적용
이 과정에서 ILM(Information Lifecycle Management)과 같은 자동화 정책을 활용하면 사전에 정의한 데이터 상태와 접근 정책에 따라 저장 위치를 변경하는 방식으로 Lifecycle을 관리할 수 있습니다.
하지만 자동화 정책을 도입할 때도 무조건 오래된 데이터를 낮은 계층으로 이동시키는 방식은 주의해야 합니다.
예를 들어 오래된 데이터라도 다음 학습에 다시 사용될 예정이라면 Hot 또는 Warm Tier에 유지하는 것이 더 효율적일 수 있습니다.
따라서 시간만을 기준으로 Tiering하는 것이 아니라 데이터의 실제 사용 패턴과 업무 중요도를 함께 고려해야 합니다.
7. Enterprise AI Storage Tiering 설계 체크리스트
실제 환경에서 Storage Tiering을 설계한다면 다음 항목부터 확인하는 것이 좋습니다.
① 데이터 Lifecycle 정의
Raw Data, Training Dataset, Checkpoint, Vector Index, 원본 문서 등 데이터 유형을 먼저 구분합니다.
② 접근 패턴 분석
각 데이터가 얼마나 자주 읽히고 쓰이는지 확인합니다.
단순한 파일 크기보다 실제 I/O 패턴을 확인하는 것이 중요합니다.
③ Hot Tier 대상 선정
GPU 학습이나 실시간 검색 과정에서 높은 성능이 필요한 데이터를 식별합니다.
④ Warm Tier 대상 선정
접근 빈도는 낮지만 일정 수준의 성능이 필요하거나 재사용 가능성이 높은 데이터를 구분합니다.
⑤ Cold Tier 및 장기보관 정책 수립
접근 빈도가 낮은 데이터와 보존 기간이 긴 데이터를 별도로 관리합니다.
⑥ ILM 자동화 검토
데이터의 상태와 사용 패턴에 따라 Storage Tier를 자동으로 이동할 수 있는지 검토합니다.
⑦ 네트워크 비용 확인
Tier 간 데이터 이동이 많아지면 네트워크 대역폭과 데이터 전송 비용이 새로운 병목이 될 수 있습니다.
⑧ Vector Database 확장성 검증
Vector Index가 커질수록 Storage Capacity뿐 아니라 Index 관리와 검색 성능을 함께 검증해야 합니다.
⑨ 보안 및 거버넌스 적용
보존 기간, 접근 권한, 데이터 분류, 개인정보 및 규제 요구사항을 Storage Lifecycle에 반영합니다.
⑩ 복구 요구사항 확인
중요한 Dataset과 Checkpoint는 단순한 저장 계층뿐 아니라 백업과 복구 전략까지 함께 설계해야 합니다.
8. Storage Tiering 비용 구조 예시(가정값)
아래 단가는 실제 클라우드·스토리지 사업자의 현재 계약가격을 의미하지 않으며, Tier별 비용 구조를 설명하기 위한 가정값입니다. 실제 비용은 스토리지 유형, 중복제거·압축, API/요청 비용, 전송비, 최소 보관기간, 계약조건 등에 따라 달라집니다.
| Tier | 데이터량 | 예시 월 단가 | 월 저장비용 | 검토 포인트 |
| Hot | 20 TB | 월 100원/TB | 2,000원 | 검색·학습 성능 |
| Warm | 50 TB | 월 60원/TB | 3,000원 | 재사용 데이터 |
| Cold | 130 TB | 월 20원/TB | 2,600원 | 장기보관 |
| 합계 | 200 TB | - | 7,600원 | 저장비용만 계산 |
* 월 저장비용 = Σ(데이터량 × 해당 Tier의 단위 저장비용). 다만 Cold Tier로 이동하면서 검색·복구가 발생하면 Retrieval 또는 데이터 전송 비용이 추가될 수 있으므로 '저장 단가가 낮다 = 전체 비용이 낮다'고 단정해서는 안 된다.
9. 결국 중요한 것은 '가장 빠른 스토리지'가 아니다
Enterprise AI Infrastructure를 설계할 때 흔히 발생하는 오해 중 하나는 AI에는 무조건 가장 빠른 Storage가 필요하다는 것입니다.
실제로는 그렇지 않습니다. 실무에서는 Storage Tier를 선택한 뒤 끝나는 것이 아니라, 데이터가 언제 어느 조건에서 Tier를 이동해야 하는지까지 정책으로 정의해야 합니다. 예를 들어 Training Dataset은 학습 기간 동안 Hot Tier에 유지하더라도 학습 종료 후 재사용 빈도가 낮아지면 Warm Tier로 이동할 수 있습니다.
반면 다음 학습에서 곧바로 재사용할 Dataset이나 복구 우선순위가 높은 Checkpoint는 단순한 경과일수만으로 Cold Tier로 이동시키지 않는 것이 적절할 수 있습니다. 따라서 Tiering 정책은 시간, 접근 빈도, 업무 중요도, 재생성 비용, 복구 요구사항을 함께 기준으로 설계해야 합니다.
AI Workload에서 중요한 것은 각 데이터의 특성에 맞는 성능을 제공하는 것입니다.
Training Dataset에는 높은 처리량이 중요할 수 있고, Vector Index에는 낮은 지연시간과 검색 성능이 중요할 수 있습니다.
반면 장기간 사용하지 않는 Raw Data는 높은 성능보다 저장 비용과 보존 정책이 더 중요할 수 있습니다.
따라서 Enterprise AI Storage의 핵심은 다음과 같이 정리할 수 있습니다.
모든 데이터를 Hot Tier에 저장하는 것이 아니라, 데이터의 Lifecycle과 Access Pattern에 따라 적절한 Storage Tier를 선택하는 것.
그리고 그 정책을 수동 운영이 아니라 Data Lifecycle Management와 자동화된 Tiering 정책으로 연결하는 것입니다.
마무리
GenAI와 RAG가 기업의 핵심 업무에 적용될수록 Storage는 단순한 데이터 저장 공간이 아니라 AI Pipeline 전체의 성능과 비용, 운영 효율성을 결정하는 핵심 인프라 구성요소가 됩니다.
특히 AI 데이터는 Raw Data에서 Training Dataset, Checkpoint, Vector Index, 원본 Payload까지 서로 다른 Lifecycle과 접근 패턴을 가지고 있습니다.
따라서 Enterprise AI Storage를 설계할 때는 다음 세 가지를 함께 고려해야 합니다.
첫째, Data Lifecycle
데이터가 생성되고 사용되며 장기 보관되는 전체 과정을 정의해야 합니다.
둘째, Storage Tiering
접근 빈도와 성능 요구사항에 따라 Hot·Warm·Cold Tier를 적절하게 배치해야 합니다.
셋째, Data Placement
AI 학습 데이터, Vector Index, 원본 문서와 같은 서로 다른 데이터 유형을 동일한 Storage Tier에 무조건 배치하기보다 실제 Workload에 맞춰 배치해야 합니다.
결국 Enterprise AI Storage의 목표는 가장 빠른 스토리지를 선택하는 것이 아니라, 필요한 데이터에 필요한 성능을 제공하면서 전체 인프라 비용과 운영 복잡성을 관리하는 것입니다.
앞선 글에서 살펴본 Storage I/O 및 고성능 스토리지 아키텍처가 AI Workload의 성능 문제를 해결하기 위한 기반이라면, 이번 글 에서는 그 위에서 AI 데이터의 Lifecycle과 Storage Placement를 어떻게 설계할 것인가에 초점을 둔 글입니다.
이러한 관점에서 Enterprise AI Storage를 접근하면 GPU 성능뿐 아니라 Storage TCO, 데이터 운영 효율성, 백업·복구 전략까지 하나의 인프라 설계 관점에서 연결할 수 있습니다.
Enterprise AI Infrastructure를 위한 High-Performance Storage Architecture 구축 실무 이어보기
- 이전 글: 2편: NVMe-oF와 병렬 파일 시스템(GPFS·WEKA·Lustre): Enterprise AI Storage Architecture 설계
- 다음 글: 4편: Enterprise AI Storage 도입 전략: GPU 활용률, TCO 최적화 및 DR 통합 아키텍처
참고자료
- SNIA (Storage Networking Industry Association), AI Storage Lifecycle Data Management
- NIST Special Publication 800-210, General Access Control Guidance for Cloud Systems
- AWS Architecture Center, Data Tiering and Storage Optimization for Machine Learning
- Google Cloud Architecture Framework, Storage Design for AI and Vector Database
- Azure Blob Lifecycle Management
- AWS S3 Storage Classes
'B2B IT 보안' 카테고리의 다른 글
| 하이브리드 클라우드 마이그레이션 1부: 온프레미스 전환의 3대 병목과 CDC 전략 (0) | 2026.09.14 |
|---|---|
| Enterprise AI Storage 도입 전략: GPU 활용률, TCO 최적화 및 DR 통합 아키텍처 (0) | 2026.09.07 |
| 엔터프라이즈 인프라 관점의 패치 화요일(Patch Tuesday) 대응: 취약점 관리와 클라우드 기반 패치 자동화 전략 (0) | 2026.08.27 |
| NVMe-oF와 병렬 파일 시스템(GPFS·WEKA·Lustre): Enterprise AI Storage Architecture 설계 (0) | 2026.08.24 |
| 기업 랜섬웨어 대응 전략: 제로트러스트와 불변 백업을 함께 설계해야 하는 이유 (0) | 2026.08.20 |


