AI 모델 학습 인프라를 확장할 때 흔히 겪는 기술적 장벽은 GPU 증설 규모에 비례하여 학습 처리 속도가 증가하지 않는 '스토리지 I/O 병목'입니다.
GPU 연산 장치는 초고속 연산을 수행할 준비가 되어 있으나, 기존 NAS와 SAN 환경의 중앙집중형 메타데이터 처리 방식이 대규모 병렬 데이터 요청을 지연시키면서 전체 학습 파이프라인의 효율을 떨어뜨리기 때문입니다.
AI 인프라의 성능을 비약적으로 끌어올리기 위해서는 레거시 스토리지의 구조적 한계를 정확히 식별하고, AI 워크로드의 입출력 특성에 최적화된 데이터 공급 체계를 갖추어야 합니다.
이 글에서는 병목이 발생하는 원인과 AI Workload의 I/O 특성을 중심으로 살펴보고, 이를 해결하기 위한 NVMe-oF·병렬 파일 시스템·GDS의 구체적인 아키텍처는 다음 편에서 별도로 다룹니다.
레거시 스토리지의 구조적 한계를 확인했다면 다음 단계는 GPU 클러스터에 적합한 데이터 전송과 파일 시스템 구조를 검토하는 것입니다. NVMe-oF와 병렬 파일 시스템 기반의 Enterprise AI Storage Architecture에서는 이러한 I/O 병목을 줄이기 위한 데이터 전송 및 스토리지 구조를 구체적으로 살펴봅니다.
특정 솔루션 소개를 넘어 엔터프라이즈 관점에서 스토리지 I/O 병목을 해결하는 핵심 아키텍처 원리를 정리해 보았습니다.
[연재] Enterprise AI Infrastructure를 위한 High-Performance Storage Architecture 구축 실무
- 1편: Enterprise AI Workload에서 Storage I/O 병목이 발생하는 이유: 레거시 NAS/SAN 아키텍처의 구조적 한계 (현재 글)
- 2편: NVMe-oF와 병렬 파일 시스템(GPFS·WEKA·Lustre): Enterprise AI Storage Architecture 설계
- 3편: GenAI 및 RAG 데이터 파이프라인을 위한 Enterprise Storage Tiering과 Data Lifecycle 설계
- 4편: Enterprise AI Storage 도입 전략: GPU 활용률, TCO 최적화 및 DR 통합 아키텍처
Enterprise AI Workload의 I/O 특성과 레거시 데이터 패턴의 차이
전통적인 Enterprise 애플리케이션인 ERP, RDBMS, 가상화(VM) 환경에서도 다양한 I/O 패턴이 발생하지만, 일반적으로 업무 특성과 데이터 접근 방식에 따라 비교적 명확한 I/O 특성을 파악할 수 있습니다.
대용량 블록을 순차적으로 읽고 쓰거나(Sequential Read/Write), 인덱스 기반의 정형화된 트랜잭션(OLTP)을 처리하는 방식이 주를 이루어 왔습니다.
반면 AI 모델 학습(Training) 및 추론(Inference) 단계에서는 기존 엔터프라이즈 애플리케이션과 다른 I/O 특성이 나타날 수 있습니다. 특히 자연어 처리(NLP), 컴퓨터 비전(CV), LLM 및 Multimodal 모델 학습에서는 대규모 데이터셋과 다수의 컴퓨팅 노드가 동시에 데이터를 처리하면서 다음과 같은 I/O 요구사항이 발생할 수 있습니다.
- Small File Random Read: 이미지, 텍스트 데이터셋, 오디오 클립 등 다수의 작은 파일로 구성된 데이터셋에서는 여러 컴퓨팅 노드가 파일을 병렬로 읽는 과정에서 메타데이터 및 Random I/O 처리 부담이 증가할 수 있습니다.
이러한 AI 워크로드에서는 단순한 디스크 처리량(Throughput)보다 메타데이터 조회 성능(Metadata Lookup), 디렉터리 탐색(Directory Traversal), 파일 오픈(Open) 및 클로즈(Close) 처리 성능이 전체 학습 속도에 더 큰 영향을 줄 수 있습니다. - 학습 Epoch 마다 반복되는 데이터 재읽기: 전체 데이터셋(Dataset)을 여러 에포크에 걸쳐 반복적으로 스캔하므로 스토리지 읽기 성능(Throughput)이 연산 전체의 병목으로 작동합니다.
- 대규모 Checkpoint Write 병목: 모델 학습 중간 단계에서 가중치(Weight)와 상태값을 저장하는 체크포인트 작업이 수행되며, 모델 규모와 분산 학습 방식에 따라 대용량 데이터가 짧은 시간에 집중적으로 Write될 수 있습니다.
이처럼 Random Small File Read와 Burst Write Checkpoint가 혼재하는 워크로드는 기존 레거시 스토리지가 최적의 성능을 발휘하도록 설계된 영역을 벗어납니다.
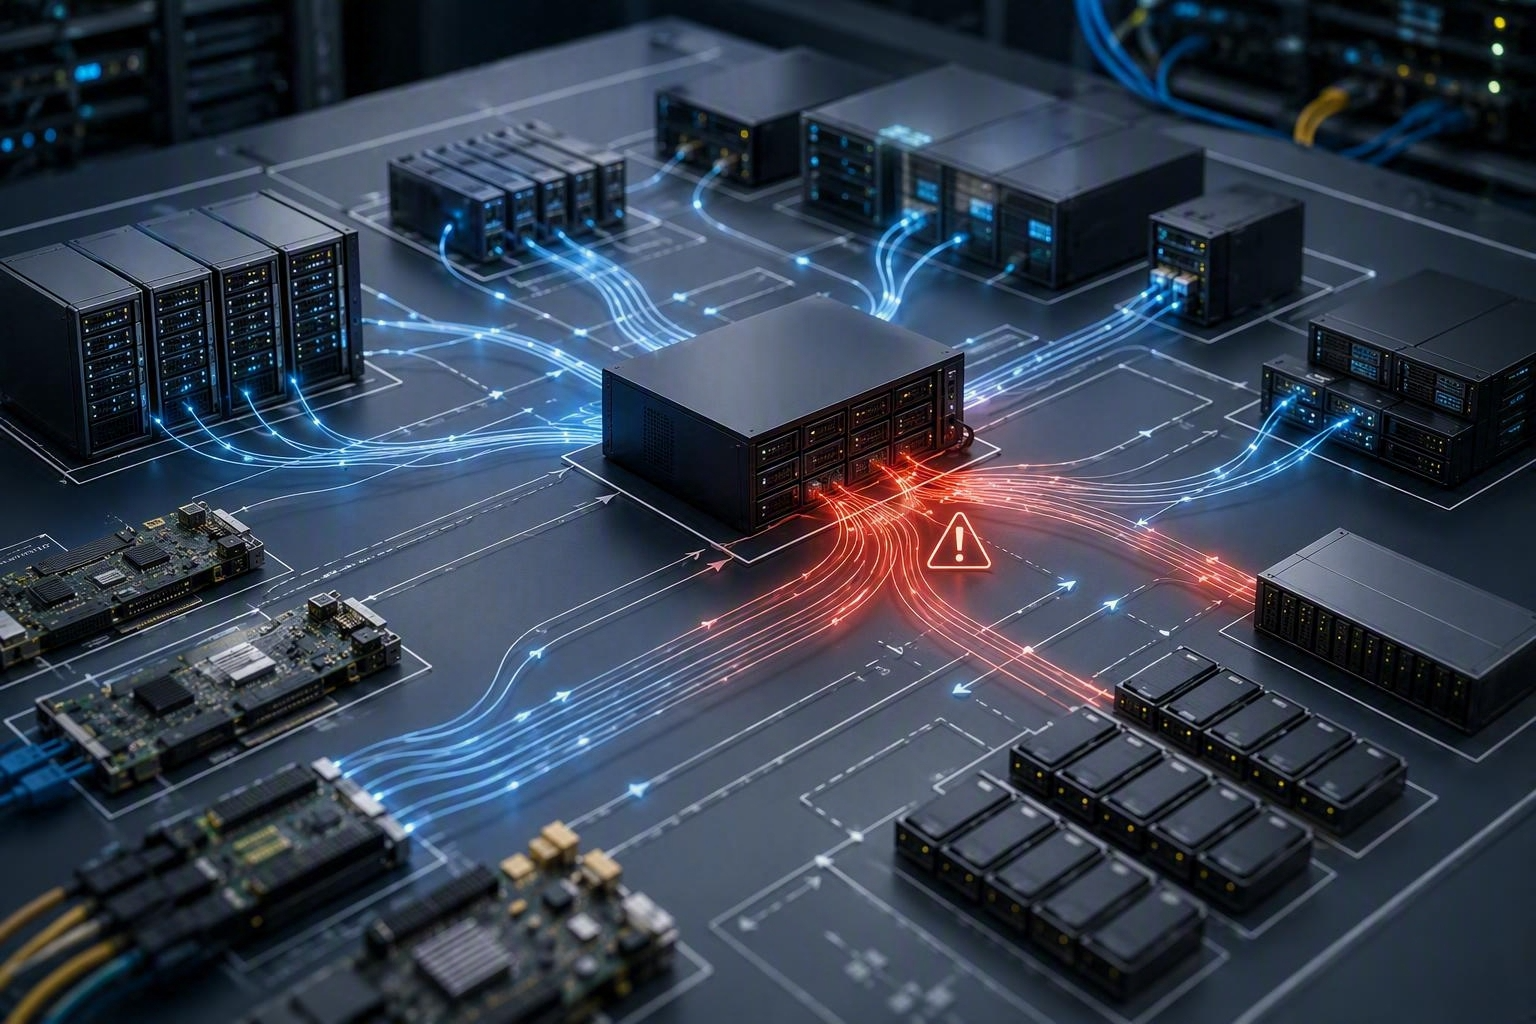
레거시 NAS/SAN 아키텍처의 3대 구조적 한계
기존 기업용 스토리지 솔루션이 AI 워크로드에서 성능 저하를 일으키는 원인은 세 가지 구조적 제약에서 비롯됩니다.
[ GPU Cluster (High Parallelism) ]
         │ (High I/O Demand)
         ▼
[ Centralized Metadata Server ] ── Bottleneck 1: Lock & Overhead
         │
[ Storage Controller (Dual/Scale-up) ] ── Bottleneck 2: Internal Bus Limit
         │
[ Kernel Page Cache & Context Switch ] ── Bottleneck 3: CPU Memory Overhead
① 중앙집중식 메타데이터 서버 및 파일 락(File Locking)
전통적인 NAS 환경에서는 파일의 위치, 크기, 권한 등의 메타데이터 처리가 특정 서버나 스토리지 컨트롤러에 집중될 수 있습니다
다수의 클라이언트가 동일한 파일이나 디렉터리에 동시에 접근하는 환경에서는 파일 락(Lock) 처리와 동시성 제어에 따른 오버헤드가 발생할 수 있으며, 이러한 특성이 특정 AI Workload에서 I/O 지연에 영향을 줄 수 있습니다 .
② Dual Controller / Scale-up 구조의 대역폭 한계
일부 전통적인 Enterprise SAN/NAS 아키텍처는 고가용성을 위해 이중화된 컨트롤러를 사용하며, 스토리지 시스템의 전체 처리 성능이 컨트롤러와 내부 데이터 경로의 구성에 영향을 받을 수 있습니다.
이와 같은 구조에서는 고가용성을 확보할 수 있는 반면, 구성에 따라 컨트롤러의 CPU 처리 능력이나 내부 PCIe 및 데이터 경로의 대역폭이 전체 스토리지 처리 성능에 영향을 줄 수 있습니다.
GPU 컴퓨팅 노드가 수십 대 이상으로 확장(Scale-out)되어도, 스토리지는 컨트롤러 병목으로 인해 필요한 데이터 공급 속도를 따라가지 못합니다.
③ 커널 영역(Kernel Space) 메모리 복사 오버헤드
전통적인 데이터 경로에서는 스토리지에서 읽은 데이터가 호스트 OS와 시스템 메모리, 네트워크 및 GPU 메모리 등의 여러 계층을 거치면서 추가적인 데이터 복사와 CPU 처리 오버헤드가 발생할 수 있습니다.
이 과정에서 호스트 CPU의 인터럽트 발생 및 메모리 복사 오버헤드가 누적되어 데이터 전송 지연을 유발합니다.
Data Movement가 GPU Utilization에 미치는 영향
GPU 컴퓨터 노드의 TCO(총소유비용) 최적화 관점에서 스토리지 I/O 병목은 연산 자원의 낭비로 직결됩니다.
GPU 활용률을 높이려면 스토리지뿐 아니라 GPU 클러스터를 실제로 수용하는 데이터센터의 전력과 냉각 조건도 함께 고려해야 합니다. AI 데이터센터 전력 병목의 원인을 살펴보면 고밀도 GPU 인프라에서 발생하는 물리적 제약을 확인할 수 있습니다.
GPU가 학습 연산을 수행하는 동안 필요한 데이터를 제때 공급받지 못하면 GPU가 연산을 충분히 수행하지 못하고 대기하는 현상이 발생할 수 있습니다. 이러한 상태는 GPU Utilization 저하나 I/O Wait 증가로 나타날 수 있으며, 스토리지와 데이터 전송 경로의 병목 여부를 함께 확인해야 합니다.
AI 학습 환경에서 데이터는 일반적으로 Storage → PCIe → NIC → Host Memory → GPU Memory 순으로 여러 계층을 거쳐 이동합니다. 이러한 Data Movement 과정에서 발생하는 복사(Copy)와 전송(Transfer) 오버헤드가 누적되면 GPU는 연산보다 데이터 대기에 더 많은 시간을 소비하게 됩니다.
스토리지 I/O 공급 속도가 GPU의 연산 처리 속도를 충분히 따라가지 못하면 GPU가 데이터 대기 상태에 놓이는 시간이 증가하고, 결과적으로 전체 학습 처리 시간이 길어질 수 있습니다.
AI Storage Architecture에서 확인해야 할 주요 차이
I/O 패턴
AI Workload에서는 Random I/O와 병렬 데이터 접근이 중요한 요소가 될 수 있습니다.
메타데이터 처리
다수의 파일과 클라이언트가 동시에 접근하는 환경에서는 메타데이터 처리 구조가 병목에 영향을 줄 수 있습니다.
데이터 전송 경로
스토리지에서 GPU 메모리까지의 데이터 이동 과정에서 발생하는 복사와 CPU 오버헤드를 줄일 수 있는 구조를 검토해야 합니다.
확장 방식
GPU 노드가 증가할 때 스토리지 용량뿐 아니라 네트워크와 I/O 처리 성능도 함께 확장되는지 확인해야 합니다.
GPU Utilization
GPU 사용률이 낮은 경우 GPU 자체의 성능뿐 아니라 데이터 공급 및 I/O 대기 여부를 함께 분석해야 합니다.

실무 관점의 Storage I/O 병목 검토 체크리스트
Enterprise AI 인프라를 설계하거나 기존 인프라의 성능 개선을 검토할 때, 단순히 스토리지를 고사양 NVMe SSD로 교체하는 것만으로는 문제가 해결되지 않습니다. 실무자는 다음 핵심 요소들을 종합적으로 평가해야 합니다.
- GPU Utilization 및 IO Wait 비율: 컴퓨팅 노드의 GPU 사용률이 낮게 유지될 때, 원인이 CPU 연산 병목인지 스토리지 I/O Read 지연에 있는지 Telemetry 데이터를 통해 구분 파악하고 있는가?
- Random Small File I/O Processing: AI 데이터셋 내 소형 파일의 메타데이터 처리와 Random I/O 성능이 실제 Workload의 동시 접근 패턴을 충분히 처리하고 있는가?
- Burst Write Checkpoint 충격 흡수력: 모델 가중치 저장(Checkpointing) 시 발생하는 일시적인 대용량 Write 트래픽이 진행 중인 학습 연산과 데이터 Read 작업을 간섭하지 않는가?
- 확장성 축(Scalability Axis): 스토리지 확장 시 용량(Capacity)뿐 아니라 네트워크 인터페이스와 처리 대역폭(Throughput)도 함께 확장되는 구조인지, 그리고 노드 증가에 따른 실제 성능 확장 효율을 확인하고 있는가?
- 데이터 이동(Data Movement) 경로를 분석하고 있는가?
Storage에서 GPU Memory까지 불필요한 데이터 복사와 네트워크 홉(Hop)이 발생하지 않는지 확인하고 있는가?
AI Infrastructure 전환을 위한 스토리지 평가 기준
Enterprise AI Workload 구축 과정에서 발생하는 스토리지 I/O 병목은 단순한 미디어(HDD vs SSD)의 문제가 아닌, 아키텍처 관점의 구조적 문제입니다.
레거시 NAS/SAN은 데이터의 안정적 보관과 비즈니스 애플리케이션의 정형 트랜잭션에는 적합하지만, 초고속 병렬 처리가 요구되는 AI 데이터 파이프라인에는 한계를 드러냅니다.
따라서 기업이 AI 인프라 확장을 계획할 때는 컴퓨팅 자원의 연산 능력뿐만 아니라, 데이터가 스토리지에서 GPU 메모리까지 이동하는 전체 경로(Data Movement)의 효율성을 함께 평가해야 합니다.
스토리지의 I/O 처리 구조와 확장성 한계를 분석하고, 필요한 경우 병렬 처리와 분산 메타데이터 구조를 지원하는 아키텍처로의 전환을 검토하는 것이 Enterprise AI Storage 설계의 주요 판단 기준이 될 수 있습니다.
이러한 구조적 한계를 해결하기 위한 방법으로 Enterprise AI Infrastructure에서는 NVMe-oF, GPU Direct Storage(GDS), 병렬 파일 시스템(Parallel File System) 등을 활용한 Storage Architecture를 검토할 수 있습니다
다음 편에서는 기존 NAS/SAN 구조와 비교하여 이러한 기술들이 어떤 방식으로 Data Movement를 단순화하고 GPU 활용률을 높이는지 실무 관점에서 살펴보겠습니다.
Enterprise AI Infrastructure를 위한 High-Performance Storage Architecture 구축 실무 이어보기
참고자료
- NVIDIA Technical Documentation – GPU Direct Storage Architecture
- SNIA (Storage Networking Industry Association) – Storage Networking Concepts
- IBM Storage Scale(GPFS) Documentation
- Lustre File System Documentation
- Linux Foundation – High Performance Storage 관련 자료
'B2B IT 보안' 카테고리의 다른 글
| NVMe-oF와 병렬 파일 시스템(GPFS·WEKA·Lustre): Enterprise AI Storage Architecture 설계 (0) | 2026.08.24 |
|---|---|
| 기업 랜섬웨어 대응 전략: 제로트러스트와 불변 백업을 함께 설계해야 하는 이유 (0) | 2026.08.20 |
| 기업 보안 예산은 어디에 먼저 투자해야 할까? 랜섬웨어·BCP 관점의 보안 인프라 의사결정 기준 (0) | 2026.08.13 |
| 클라우드 전환 환경에서의 엔터프라이즈 DB 재해복구(DR) 아키텍처 설계와 실무 검토 지침 (0) | 2026.08.10 |
| 제로 트러스트 아키텍처 기반 데이터 보안 시스템 도입 전략 및 적용 사례 (2) | 2026.08.06 |


